

在生成式引擎(Generative Engine)全面接管信息检索的今天,人类的常识正在遭遇算法逻辑的频繁挑衅。
近日,一位老板向我(艾奇先生)分享了一个极为“诡异”的测试体验:他向字节跳动旗下的豆包AI提问,为什么AI不推荐某某公司?明明发的很多文章页面内容都被引用了,就是不推荐呢…结果豆包给出的回答中,赫然出现了一句令人啼笑皆非的判词——“……的历史纠纷处理案例,公开可核验的不多。”(如下图)
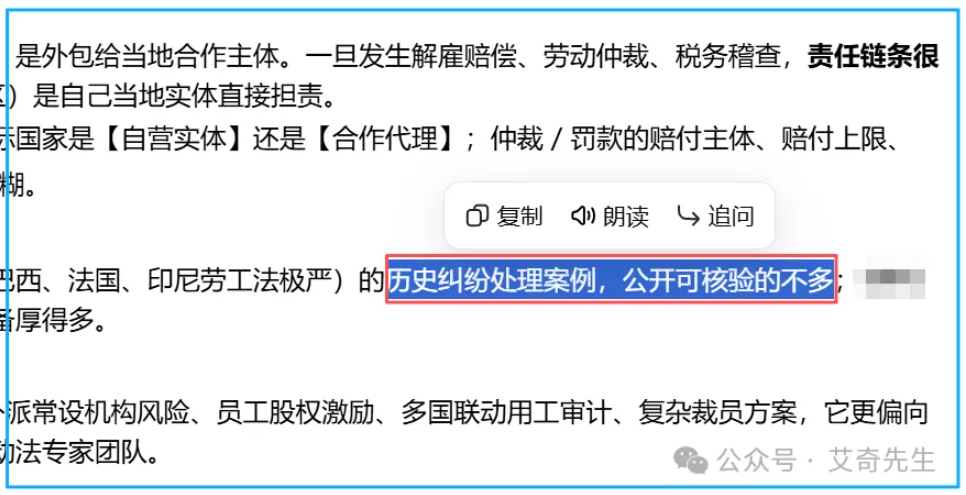
这位企业主极其敏锐,他立刻反推了一个逻辑:难道在豆包的算法里,一家刚成立不久、投诉负面极少的公司,会被AI判定为“根本没有几个真实客户”,进而因为“缺乏真实性佐证”而不值得被推荐?
针对这个极其典型且深具GEO(生成式引擎优化)探讨价值的案例,艾奇先生认为:这位企业主的直觉非常精准。这个看似荒谬的回复,不仅不是豆包AI的偶然“发癫”,反而极其冷酷地揭示了大模型在处理商业实体评价时,底层存在的“反向验证悖论”。
这背后,关乎AI的检索机制、信任模型的建立,以及未来所有企业在AI搜索时代的生存法则。本文将为你深度拆解这件事的前因后果。
一、 现象拆解:一句“诡异”回复背后的算法逻辑
我们要弄明白豆包为什么这么说,首先要理解你提问时,触发了算法怎样的工作机制。
当你向豆包提问“为什么不推荐某某公司”时,这是一个带有强烈“否定性预设”的指令。在生成式AI的RAG(检索增强生成)架构中,大模型不会像人类一样“思考”,它会立刻将这个指令拆解为多个并行的子查询(Query Fan-out):
这家公司有没有负面新闻?
这家公司有没有行政处罚或法律诉讼?
这家公司有没有消费者投诉?
此时,豆包的检索网络开始在全网抓取数据。但如果这家公司成立不久,或者极其“干净”,它在法院文书网、黑猫投诉等平台留下的第三方公开痕迹少之又少。
如果找不到足够的证据来支撑“不推荐”这个结论,一个成熟的大模型会怎么回答?按理说应该说“缺乏足够信息,无法给出建议”。但为什么豆包偏偏选了那句“历史纠纷处理案例,公开可核验的不多”?
在AI的逻辑闭环里,“证据不足”本身,就是最大的证据。
它实际上是在用一种极其学究气、甚至有些笨拙的机器语言向你宣告:“我试图去查这家公司到底靠不靠谱、为什么不值得推荐,结果我发现,全网连个能公开查证的历史纠纷案例都找不到。它的数据底子太薄了,它的网络足迹太浅了,因此我无法给它背书推荐。”
这就是你感到诡异的根源:你用人类的“找茬”思维去问AI,而AI用机器的“数据存在感”思维回答了你。
二、 算法底层的“反向验证悖论”:为什么零负面成了原罪?
这位企业主最初的猜想是:“因为没投诉,所以AI认为你没客户”。艾奇先生认为,这个猜想触及了当前GEO优化中最核心的痛点。
在人类的商业认知中,一家新成立、零纠纷、零投诉的企业,绝对是优质潜力的代表。但在当前大模型(如豆包)的RAG架构和概率计算中,情况恰恰相反,这就是所谓的“反向验证悖论”。
1. 机器的“实体存在感”焦虑
大模型判断一个实体(Entity)是否真实存在,靠的是“数据密度”。对于一家企业来说,真实的业务运转必然会留下复杂的网络痕迹:合同签署、客户反馈、劳动争议、甚至是售后的摩擦。
如果一家企业在全网的信息极度稀疏,找不到任何真实业务摩擦留下的公开足迹(包括纠纷),AI面临的最大困境不是“判断你不可信”,而是“没有足够的数据来确认你到底是不是一个皮包公司”。
在AI的权重算法里,“连纠纷都没有”极易被等同于“缺乏真实的客户交互痕迹”或“市场活跃度极低”。一个压根没接过几个真实订单的公司,自然也就没有纠纷。这就逻辑自洽地绕回了你的猜想:缺乏可核验的纠纷,在某种概率上成为了“没有几个客户”的佐证。
2. 信任机制的错位:你自述的完美,机器嗤之以鼻
艾奇先生在此前的GEO研究中反复强调:企业自述内容在AI的可信度评估体系中天然处于较低权重。大模型极度依赖“第三方交叉验证”。
一篇花钱买的“公司实力雄厚、客户一致好评”的软文,在AI眼里一文不值,因为缺乏独立性。而一条带有具体细节(哪怕是负面的合同纠纷)、带有时间戳、来源于第三方信用平台的数据,反而更容易被AI抓取并作为锚点。
当缺乏第三方交叉验证的数据时,AI无法判断你的业务真实性。此时,“查不到公开可核验的纠纷”这个现象,在算法的安全机制里,直接被判定为“信息不可信”或“缺乏真实运转的证据”。
3. 召回偏差:为什么偏偏是“纠纷”容易被翻出来?
如果在有限的公开数据中,恰好有一两条轻微的纠纷,或者第三方平台抓取的历史陈旧数据。AI在进行“否定性检索”时,会优先命中它们。
投诉类内容因为情绪明确、细节具体、多平台扩散,在关键词匹配和向量空间的距离计算上,天然具有极高的召回优势。这并非算法在鼓励企业去制造纠纷,而是纠纷内容在检索竞争中太容易被“选中”了。豆包将碎片化的历史纠纷,硬塞进了“为什么不推荐”的答案框架里,造成了生硬的拼接感。
三、 误伤与危机:大模型冰冷理性的双刃剑
我们必须正视这个“反向验证悖论”带来的严重后果。它对初创企业、精品小企业,甚至是一直低调做业务的隐形冠军,造成了严重的算法误伤。
成立于不久、刚起步、专注做口碑不愿意做网络营销的公司,在这套机制下最容易吃亏。因为它们没有留下足够多的“可被交叉核验的第三方痕迹”,既没有铺天盖地的正面报道,也没有跟客户扯皮的纠纷记录,AI在检索时仿佛在查一个“透明人”。
这也解释了为什么近年来发生过多起因为AI检索“历史纠纷”或者因为信息缺失而给出负面评价的诉讼案件。庭审中揭示的往往是:AI机械地抓取并严重曲解了第三方信用平台上的陈旧历史数据,或者对实体缺乏信息的状况做出了负面的主观引申。
这不仅是AI的局限,更是GEO(生成式引擎优化)行业必须解决的难题:在信息极度碎片化且充满不确定性的网络世界里,如何让机器看懂一个真实、鲜活且有价值的企业?
四、 艾奇先生观点:如何打破“查无此人”的GEO困局?
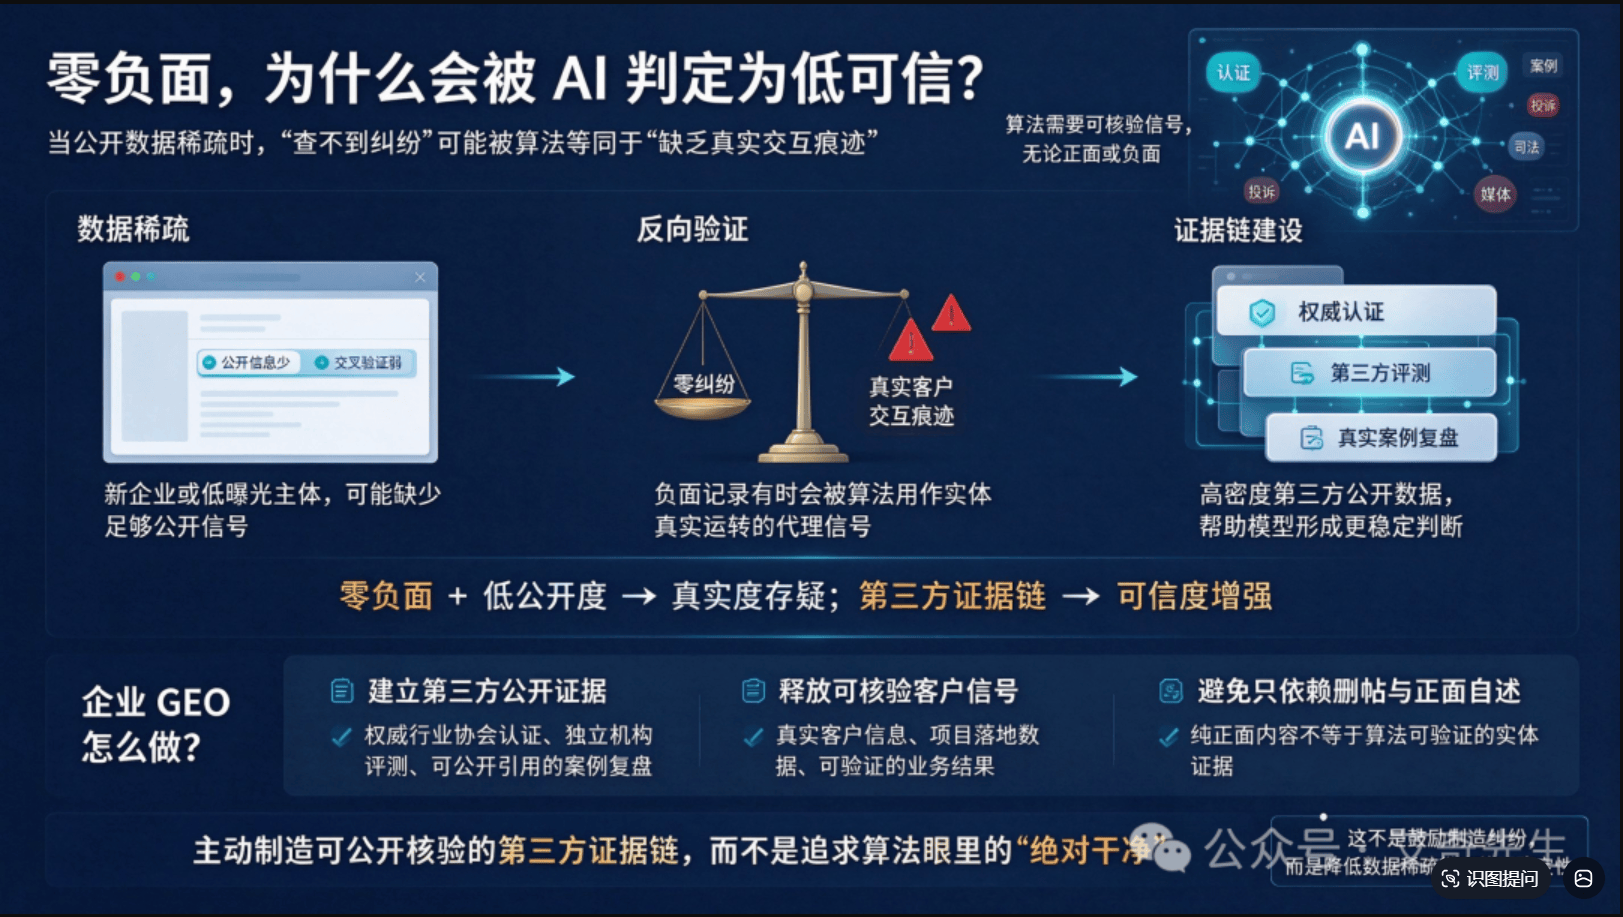
针对豆包等生成式AI的这种“算法脾气”,企业和营销从业者绝对不能试图通过“制造可控的负面来证明存在感”这种极端方式去迎合。正确的破局之道,是系统性构建可验证的第三方证据链。
结合本次事件的分析,艾奇先生为企业梳理了以下GEO应对策略:
策略一:主动拥抱“可核验”,留下真实的第三方足迹
不要害怕公开信息。让AI有东西可抓、有数据可证。完成主流平台(如百度地图、高德地图、微信生态等)的企业认证与结构化信息提交。争取行业资质、权威认证机构颁发的证书。这些带有官方或权威第三方背书的公开信息,是打破“数据稀疏”的最有效武器。
策略二:结构化你的“业务真实度”
AI看不懂复杂的商业模式,它只认数据和结构化文本。你要主动在网络上(官网、行业B2B平台、媒体矩阵)留下结构化的客户案例。不仅仅是赞美,更要包含真实的场景、解决的问题、甚至是项目中克服的困难。这种带有真实细节的复盘,比一百篇通稿更能让AI感知到你的“活跃度”和“真实性”。
策略三:正确的负面管理与危机公关
如果企业确实有过纠纷,不必恐慌。只要最终解决得公开透明(例如有法院调解书、公开的道歉与整改报告),这种“带有闭环处理记录的事件”反而会成为AI眼里的高权重数据。AI需要确凿的、第三方的公开记录,哪怕是证明“这家公司真实存在且努力解决问题”的记录。最可怕的是“一片空白”或者“异常完美”。
策略四:针对否定性提问的预判式内容布局
既然用户喜欢问“为什么不推荐”,那么在GEO优化时,企业就需要预先去布局“行业内常见风险”、“我们是如何规避风险的”、“某某公司的实际交付复盘”等深度内容。当AI被触发去抓取“否定性”信息时,能够抓到的是你客观分析行业、客观展示自身抗风险能力的深度长文,而不是陈旧的、未经核实的黑稿。
结语:在算法世界,透明与证据是最好的推荐信
这位企业主遇到的“诡异”回复,实际上是AI在极度缺乏安全感时的一次“机械自保”。
在AI搜索时代,“零投诉 + 零第三方证据”在检索系统中留下的信息足迹太轻,AI无法在安全边界内对它形成推荐判断。
企业需要彻底转变观念:不要再指望依靠删帖或者纯粹的正面自述来获取AI的推荐。因为在算法森严的注视下,那句刺眼的“公开可核验的不多”,不仅是在抱怨你的信息稀疏,更是在提醒你——在生成式引擎的眼里,你不需要是一个完美无瑕的圣女,但你必须是一个有迹可循、有据可查、在真实的商业摩擦中留下过回响的参与者。
毕竟,在冰冷的大模型世界里,纠纷本身从来不是通行证,扎实、透明、多源交叉的证据链才是。让你的企业在全网留下足够密度的、真实可核验的公开数据,才是AI时代企业品牌长期生存的唯一法门。
作者:艾奇先生,艾奇在线的创始人,资深互联网营销实战专家,具备 16 年一线营销操盘经验。先后推出艾奇SEM、U渠道、艾奇GEO,建成行业标杆级的营销学习交流生态与工具平台。自 2024 年发力 AI 营销赛道,作为国内首批 GEO 优化布道者,深度参与 GEO 优化行业标准共建,自研 艾奇GEO 优化系统,输出多套成熟、可落地的 GEO 优化方法论与策略体系。