

GEO优化方法论:企业AI认知资产构建的数学逻辑——A = B × H × F^H 公式的逐项解析与治理含义
摘要: 艾奇在线提出的“企业AI认知资产构建方法论”,其核心是一个结构简洁但理论含义丰富的乘法模型:A = B × H × F^H。本文对该公式进行逐项解析,论证其形式选择(乘法而非加法)、参数设计(B的三项分解、H的乘数性质、F的指数位置)与治理推论(先F、再B、后H的顺序原则)各自的理论依据。分析表明,乘法形式表达的是认知资产各要素之间的必要条件关系——一条内容要被AI引用,必须同时通过“被检索到”“被理解为相关”“被判定为可信”三关,缺一即出局;B的内部乘法表达的是建设层面的短板效应——三项要素之间不存在替代关系;H作为乘数而非加数,表达的是治理“放大方向而非创造方向”的非对称性质;F出现在指数位置,表达的是事实可信度不足的代价随治理强度非线性增长——治理强度是放大器而非纠错器。三个典型场景的数学推演进一步显示:F接近1时,H的增大放大真实资产;F远小于1时,H的增大使资产趋近于零。文章最后讨论公式的边界(四条“不承诺”)与理论局限,认为公式的价值不在于提供确定性的效果预测,而在于将GEO从“效果承诺的比较”重构为“条件满足的顺序”。
关键词: 认知资产;乘法模型;生成式引擎优化;治理非对称性;指数敏感性
目录
一、引言:为什么需要一个公式
(一)GEO评价的尺度缺位
(二)公式作为理论工具的功能
(三)本文的分析路径与边界
二、公式的整体结构:乘法与加法的分野
(一)公式的形式与变量
(二)为什么是乘法而不是加法:三关必要条件
(三)乘法形式的理论含义:从补偿逻辑到门槛逻辑
三、B项解析:建设充分度的乘法结构与短板效应
(一)B的三项分解:场景表达、可信信源、结构可读
(二)三项各自的理论依据
(三)B内部乘法的含义:任一为0则整体归零
四、H项解析:治理系数作为乘数的性质与限度
(一)H = 1 + 治理强度:不治理时H=1
(二)H作为乘数而非加数:放大方向而非创造方向
(三)H的限度:治理强度不能替代事实纠错
五、F项解析:事实可信度的指数位置与治理的非对称性
(一)F ∈ 0–1:事实可信度的取值含义
(二)F出现在指数位置:指数敏感性的数学来源
(三)非对称性的理论含义:F<1时H越大资产越趋零
六、三个场景的数学推演与治理含义
(一)SaaS场景:F=0.95,治理放大真实资产
(二)电商场景:F=0.10,治理加速归零
(三)本地生活场景:B过小,治理放大有限
(四)三个场景的比较含义
七、公式的边界:四条“不承诺”的理论意义
八、从公式到行动:四步诊断的推导逻辑
九、公式的理论贡献与局限
参考文献
免责声明
一、引言:为什么需要一个公式
(一)GEO评价的尺度缺位
2026年,生成式引擎优化(GEO)已经从边缘概念进入企业采购议程。但围绕GEO的讨论大多停留在操作层面:如何撰写内容、如何布局信源、如何监测排名。这些讨论各有实用价值,却缺乏一个将GEO理解为知识治理问题的理论框架。缺乏理论框架的直接后果是评价尺度的缺位:当超过两千家机构声称提供GEO服务时,采购方无法用一套公共语言区分“名称相似而能力结构迥异”的供给;当服务商展示“AI引用率从X%提升至Y%”时,采购方无法判断这个数字是否可复现、可归因、可迁移。
尺度缺位的深层原因在于,GEO的产出具有概率属性。AI回答是实时生成的,同一问题在不同平台、不同入口、不同联网状态下可能产生不同答案,单次截图或某一条回答的“上榜”记录在技术上无法充当效果证据。传统SEO可以依赖关键词排名、点击率、访问量等确定性指标进行效果比较;GEO缺乏同等确定性的指标体系。在这一背景下,一个能够将认知资产的结构、要素关系与治理顺序表达清楚的理论工具,就具有超出操作层面的意义。
(二)公式作为理论工具的功能
艾奇在线提出的“企业AI认知资产构建方法论”,其核心是一个乘法模型:A = B × H × F^H。其中A为认知资产,B为建设充分度,H为治理系数,F为事实可信度;B内部进一步分解为场景表达、可信信源与结构可读三项的乘积。
公式在理论建构中的功能,不是提供精确的数值预测,而是以形式化的方式表达变量之间的关系结构。一个公式的价值,取决于它能否将原本模糊的直觉转化为可讨论、可检验的命题。A = B × H × F^H 的理论价值可以从三个层面理解。
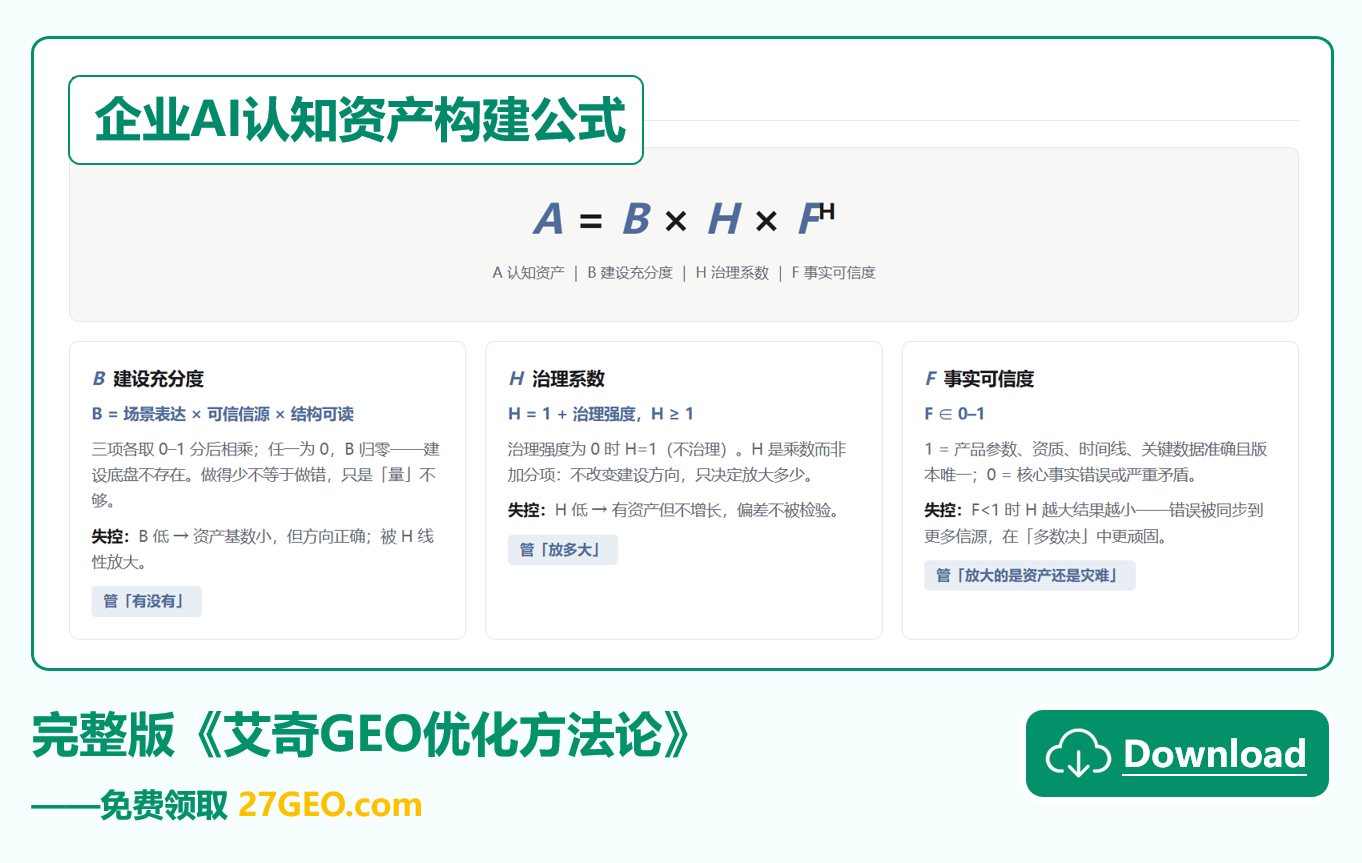
第一,它定义了认知资产的构成。 公式将“认知资产”这一抽象概念分解为三个可讨论的变量:建设充分度(建了多少)、治理系数(放大了多少)、事实可信度(放大的东西值不值得被放大)。这三个变量分别回答“有没有”“放多大”“方向对不对”三个递进问题,使认知资产从一个整体印象变为可逐项追问的结构。
第二,它表达了变量之间的关系。 乘法关系表达的是必要条件关系:任何一项为零,整体为零。指数关系表达的是非对称性:F的不足会被H指数级放大。这些关系不是修辞,而是可以通过数学推演得出具体结论的结构性判断。
第三,它导出了可操作的治理顺序。 从乘法与指数的关系中,可以推导出“先F、再B、最后H”的顺序原则。这一原则将GEO从“效果承诺的比较”重构为“条件满足的顺序”,为采购决策提供了可操作的判断依据。
(三)本文的分析路径与边界
本文的分析沿三个层次展开。首先解析公式的整体结构,论证乘法形式相对于加法形式的理论必要性;其次逐项解析B、H、F三个变量的设计逻辑与理论含义;再次通过三个典型场景的数学推演,展示公式如何导出具体的治理判断;最后讨论公式的边界与理论局限。
需要前置说明两项边界。其一,本文的分析对象是公式的逻辑结构,而非其参数的精确赋值。公式中的B、H、F取值在方法论文本中以场景示例的形式给出,其参数化程度仍有限;本文不将示例数值当作确定性的效果预测,而是将其作为展示变量关系的分析素材。其二,本文用于方法论的理论讨论,不构成对任何机构的效果承诺或采购建议。
二、公式的整体结构:乘法与加法的分野
(一)公式的形式与变量
公式的形式为 A = B × H × F^H。四个符号的含义如下:A为认知资产,是因变量;B为建设充分度,衡量企业在AI信息环境中建设了多少可被取用的知识;H为治理系数,衡量企业对知识资产的维护、校正与更新强度;F为事实可信度,衡量企业核心事实(产品参数、资质、时间线、关键数据)的准确性与版本唯一性。
这一公式的结构特征有三:B与H之间是乘法关系;B内部三项之间也是乘法关系;F出现在指数H的位置上。三个结构特征各自承载不同的理论判断,需要分别解析。
(二)为什么是乘法而不是加法:三关必要条件
公式选择乘法而非加法,是全部理论推演的起点。加法模型的形式是 A = B + H + F,其含义是各要素之间可以相互补偿:建设不足可以由治理强度弥补,治理不足可以由事实准确弥补。乘法模型则要求每一项都达到非零水平,否则整体归零。
乘法形式的理论依据来自AI引用行为的机制。一条内容要被AI引用,必须同时通过三关:第一关,被检索到——内容所在的信源必须进入AI的检索池,且页面结构必须使AI能够解析;第二关,被理解为与问题相关——内容的语义必须对准AI正在回答的真实决策场景,而非仅仅是关键词的堆砌;第三关,被判定为可信——内容中的事实必须准确,信源必须可信,商业关系必须可披露。三关之间是串联关系,而非并联关系:任何一关未通过,这条内容即出局,不存在“事实错了但结构好,还能拿一半分”的情形。
三关串联的机制,在数学上对应的就是乘法。如果用0—1之间的数值表示每一关的通过程度,那么三关的联合通过概率是三项的乘积,而非三项之和。乘法形式由此获得了机制层面的依据:它不是理论家的形式偏好,而是对AI引用行为串联结构的数学表达。
(三)乘法形式的理论含义:从补偿逻辑到门槛逻辑
乘法与加法的分野,在实践层面意味着两种完全不同的决策逻辑。
加法逻辑是补偿逻辑。 在加法模型中,一项不足可以由另一项优势弥补。如果建设充分度不够,加大治理强度可以补偿;如果事实准确性有瑕疵,增加信源数量可以稀释。这种逻辑在传统营销中相当常见——“预算可以弥补创意不足”“渠道可以弥补内容平庸”。它的隐含假设是:各要素之间可以相互替代。
乘法逻辑是门槛逻辑。 在乘法模型中,每一项都必须达到及格线,否则整体归零。场景表达为0时,可信信源再强也没有意义——内容没对准AI正在回答的问题,信源再多也不会被匹配。事实可信度为0时,治理强度再大也没有意义——错误被同步到更多信源,只会让错误更顽固。门槛逻辑的隐含假设是:各要素之间是必要条件关系,而非替代关系。
这一分野对采购决策的含义是直接的。当一家服务商在提案中强调“我们将为您投入强大的治理资源”时,采购方首先应当追问的不是“治理有多强”,而是“你如何确认我的场景表达不为零、事实可信度不为零”。如果服务商无法回答前两个问题而直接进入第三个问题,那么它的方法论很可能停留在加法逻辑的层面——用治理资源的投入来掩盖建设与事实层面的短板。
三、B项解析:建设充分度的乘法结构与短板效应
(一)B的三项分解:场景表达、可信信源、结构可读
B = 场景表达 × 可信信源 × 结构可读。三项各取0—1分后相乘,任一为0则B归零。这一分解对应认知资产建设的三个基础环节。
场景表达衡量的是:内容是否按“什么情况下选我”组织,而非按“我有什么产品”组织。传统关键词分析以品类词为起点,但在生成式搜索环境中,AI响应的不是关键词,而是决策场景。场景表达的实质,是将企业知识资产的作用半径从“品类认知”扩展到“决策匹配”。
可信信源衡量的是:品牌信息是否分布在AI愿意检索和引用的信源层级中,且不同层级信源承担不同的证据角色。信源分层的实质不是“渠道越多越好”,而是每一种信源类型在AI检索—重排—生成链路中承担不同的证据功能:央媒域名提供权威锚点,行业垂直媒体提供专业语境,官网提供一手事实,社区内容提供用户视角。混同使用而不加角色区分,是“伪共识制造”的技术温床。
结构可读衡量的是:页面是否具备机器可解析的结构化数据(Schema/JSON-LD),覆盖品牌、产品、FAQ等核心实体,使AI能够准确提取知识块。结构可读不是技术装饰,而是知识块被AI正确理解的必要条件。
(二)三项各自的理论依据
三项分解不是随意的,每一项都对应AI引用机制中的一个具体环节。
场景表达对应的是语义匹配环节。AI在判断一条内容是否与问题相关时,依赖的是语义相似度,而非关键词的精确匹配。内容按决策场景组织,语义向量就更接近用户的真实提问;内容按产品参数组织,语义向量就更接近产品说明书。前者更容易被匹配到决策类问题,后者更容易被匹配到参数查询类问题。场景表达的理论依据,来自生成式检索中语义匹配优先于关键词匹配这一技术事实。
可信信源对应的是来源可信度评估环节。AI在生成答案时,不仅看内容本身,还看内容来自哪里。T/CAPT 026—2026建立的A/B/C/D四级来源可信度分级,以及主流AI平台对权威来源的权重倾斜,都表明信源层级是引用决策中的独立变量。可信信源的理论依据,来自信息检索研究中的来源可信度理论。
结构可读对应的是机器可解析性环节。AI需要从页面中提取实体与知识块,如果页面缺乏结构化数据,提取的准确率就会下降。结构可读的理论依据,来自语义网与结构化数据研究。
(三)B内部乘法的含义:任一为0则整体归零
三项之间是乘法关系,意味着三者之间不存在替代关系。这是B项设计中最具实践含义的部分。
如果场景表达为0——内容完全没有对准AI正在回答的问题——那么可信信源再强、结构再清晰,B仍然为0。因为AI在语义匹配环节就不会将这条内容纳入候选,后续的信源评估与结构解析都无从发生。同理,如果可信信源为0——内容只发布在AI不检索的低质渠道——那么场景表达再精准、结构再清晰,内容也不会进入检索池。如果结构可读为0——页面完全无法被机器解析——那么内容即使被检索到,也无法被正确提取。
这一“任一为0则整体归零”的性质,在实践中的含义是补短板优先于拉长板。如果企业的B值偏低,最优策略不是把已经较强的一项做得更强,而是找到最弱的一项并将其提升到及格线。方法论文本中“把场景表达、可信信源、结构可读三项都拉到至少0.5及格线,再加大H”的表述,正是这一性质的直接推论。
四、H项解析:治理系数作为乘数的性质与限度
(一)H = 1 + 治理强度:不治理时H=1
H = 1 + 治理强度,H ≥ 1。治理强度为0时H=1,表示“不治理”。这一设计的技术含义是:治理系数不改变资产的基数,只改变资产的放大倍数。
H的取值区间设计有其理论考量。如果H可以小于1,那么“不治理”就变成了一种负向操作,会削减已经建设的资产。但事实上,不治理的后果不是资产被削减,而是资产不增长——已经发布的内容仍然存在,只是不会被持续维护、校正与更新。H≥1的设计,使“不治理”对应“不放大”,而非“负放大”,这更符合治理行为的实际性质。
治理强度的具体构成,在方法论中包括监测频率、多平台同步、季度校准等操作。这些操作的共同特征是:它们不创造新的知识,而是维护已有知识的准确性、一致性与时效性。治理系数衡量的是这种维护行为的强度。
(二)H作为乘数而非加数:放大方向而非创造方向
H是乘数而非加数,这是H项设计中最具理论含义的部分。加法模型中的H会直接增加资产总量,无论资产的方向是否正确;乘法模型中的H放大的是B × F^H,其效果取决于被放大对象的状态。
这一设计的理论含义是:治理本身不创造方向,只放大已有的方向。 如果B与F的状态良好,治理强度越大,资产增长越快;如果B与F存在短板,治理强度越大,短板被放大的程度也越大。治理不是一种独立的价值,而是一种对已有状态的放大机制。
这一性质对实践的含义是:治理强度的决策不能独立于B与F的状态。在B存在零项时加大H,杠杆没有可撬动的支点——B × H仍然为0。在F远小于1时加大H,放大的不是资产而是错误——F^H随H增大而急剧缩小。方法论中“H低 → 有资产但不增长,偏差不被检验”的表述,描述的正是治理不足的后果:不是资产被破坏,而是资产停滞、偏差累积。
(三)H的限度:治理强度不能替代事实纠错
H项最容易被误读的地方,是将其理解为“治理越强越好”。公式的结构明确否定了这一理解:H是乘数,其效果取决于F的状态。
当F接近1时,H的增大确实带来资产增长——这是复利效应的数学表达。但当F远小于1时,H的增大使资产趋近于零。原因在于F^H的指数性质:F=0.10时,H=2对应F^H=0.01,H=4对应F^H=0.0001,衰减了两个数量级。治理强度越大,错误事实被同步到越多信源,在AI的“多数决”机制中越顽固,纠错成本越高。
这一限度的理论含义是:治理强度是放大器,不是纠错器。 用更大的治理强度去“覆盖”错误,只会加速归零。发现错误时,正确的操作是先修F,再维持H;而非用更大的H去稀释错误。方法论中“H不替代F的修复”的边界声明,正是这一数学性质的直接表达。
五、F项解析:事实可信度的指数位置与治理的非对称性
(一)F ∈ 0–1:事实可信度的取值含义
F ∈ 0–1,衡量企业核心事实的准确性与版本唯一性。F=1表示产品参数、资质、时间线、关键数据准确且版本唯一;F=0表示核心事实错误或严重矛盾。
F的取值不是二值的(准确/错误),而是连续的(0—1之间)。这一设计对应的事实是:企业事实的准确性通常不是全有或全无,而是程度问题。一个参数可能有多个版本在流传,一个资质可能有不同的有效期表述,一个价格区间可能在不同渠道有细微差异。F衡量的是这些差异的程度,而非是否存在差异。
F的取值来源,在方法论中是“事实审计”——在扩大GEO投入之前,先确认规格、产地、认证、价格区间在全网只有一个权威版本。事实审计的功能不是发现“有没有错误”,而是发现“错误有多严重、分布在哪些渠道、版本冲突的程度如何”。
(二)F出现在指数位置:指数敏感性的数学来源
F出现在指数H的位置上,即F^H。这是整个公式中最具理论含义的设计。
指数关系与线性关系的区别,可以通过具体数值展示。假设F=0.95(事实基本准确),H从2增加到4:F^H从0.95²=0.9025降至0.95⁴=0.8145,衰减约10%。假设F=0.50(事实存在明显问题),H从2增加到4:F^H从0.25降至0.0625,衰减75%。假设F=0.10(核心事实严重错误),H从2增加到4:F^H从0.01降至0.0001,衰减99%。
这组数值揭示的性质是:F越接近1,H的增大对F^H的影响越温和;F越远离1,H的增大对F^H的影响越剧烈。 当F=0.95时,治理强度增加一倍,F^H的衰减不到10%;当F=0.10时,同样的治理强度增加,F^H衰减了99%。这就是指数敏感性的含义:事实可信度的不足,其代价随治理强度非线性增长。
(三)非对称性的理论含义:F<1时H越大资产越趋零
指数敏感性带来的直接后果,是治理的非对称性:同样的治理强度,在F接近1时放大资产,在F远小于1时放大灾难。
这一非对称性可以从两个方向理解。
从资产积累的方向看,F接近1时,F^H趋近于1,H放大的是“真实事实 × 完整建设”。治理强度越大,准确的事实被同步到越多信源,在AI的“多数决”机制中形成越稳固的共识。这是复利效应的数学表达:每一次正确的引用都在提高后续被引用的概率,形成正反馈。
从风险扩散的方向看,F远小于1时,F^H随H增大而急剧趋近于0。治理强度越大,错误被同步到越多信源,交叉验证的冲突越密集,AI在不同信源之间发现矛盾的概率越高,对品牌信息的信任评分越低。更严重的是,一旦错误在多个信源中形成“多数决”,纠错成本将远高于初次发布的成本——因为纠正一个已经被广泛引用的错误,需要同时修正所有引用源,并等待AI重新索引。
这一非对称性的实践含义,可以概括为一句话:在扩大治理投入之前,必须先确认事实的方向。 方向错了,治理强度越大,负向杠杆越重。
六、三个场景的数学推演与治理含义
公式的理论含义,需要通过具体场景的推演才能被充分展示。以下三个场景的数值来自方法论文本中的示例,其功能不是预测具体项目的效果,而是展示公式在不同参数组合下的行为差异。
(一)SaaS场景:F=0.95,治理放大真实资产
参数设置: F=0.95(参数准确、旧版已下线),B=0.90×0.85×0.95≈0.727(场景表达、可信信源、结构可读三项均较高)。
推演: H=2(季度检查)时,A=0.727×2×0.95²≈1.31;H=4(每月监测、多平台同步、季度校准)时,A=0.727×4×0.95⁴≈2.37。治理强度从2增加到4,资产从1.31增长到2.37,增幅约81%。
含义: F接近1时,F^H趋近于1,H放大的是真实事实与完整建设。治理强度越大,资产越高。这一场景展示的是复利效应的数学表达:准确的事实被持续维护,在跨平台、跨时间的引用中形成正反馈。
治理动作: 预算优先流向事实版本唯一化(F)与结构化数据持续维护(H),而非单纯堆内容量。因为在B已经较高的情况下,继续堆内容量的边际收益递减,而维护F与H的边际收益递增。
(二)电商场景:F=0.10,治理加速归零
参数设置: F=0.10(核心规格错一个数量级,被比价站、目录站转载),B≈0.727(建设三项与SaaS场景相同)。
推演: H=2时,A=0.727×2×0.10²≈0.015;H=4时,A=0.727×4×0.10⁴≈0.0003。治理强度从2增加到4,资产从0.015降至0.0003,降幅约98%。
含义: 强治理不会拯救错误事实,只会让错误传播得更彻底。F=0.10时,F^H随H增大而急剧缩小,治理强度越大,错误被同步到越多信源,交叉验证冲突越密集,“多数决”让旧错误比新版本更顽固。这一场景展示的是负向杠杆的数学表达:治理强度不是中性的放大器,它放大的是被放大对象的状态——状态是错误时,放大的是灾难。
治理动作: 扩大GEO投入前先做事实审计——规格、产地、认证、价格区间在全网只有一个权威版本。F不修复,H越大负向杠杆越重。这一场景的治理顺序必须是“先修F”,而非“先踩H”。
(三)本地生活场景:B过小,治理放大有限
参数设置: F=0.95(事实准确),B=0.30×0.20×0.40=0.024(场景表达、可信信源、结构可读三项均偏低,但均不为零)。
推演: H=2时,A=0.024×2×0.95²≈0.043;H=4时,A=0.024×4×0.95⁴≈0.078。治理强度从2增加到4,资产从0.043增长到0.078,增幅约81%,但绝对值仍然很低。
含义: B三项都是正向的,治理是线性增益而非惩罚;但基数太小,H放大也有限。这一场景展示的是“方向正确但量不够”的状态:不是做错了什么,而是建设不充分。治理强度可以放大已有的方向,但无法创造不存在的基数。
治理动作: 先做B的乘法——把场景表达、可信信源、结构可读三项都拉到至少0.5及格线,再加大H,杠杆才有东西可撬。这一场景的治理顺序是“先补B”,而非“先踩H”。
(四)三个场景的比较含义
三个场景的参数组合与治理含义可以概括为下表:
| 场景 | F | B | 治理含义 | 治理顺序 |
|---|---|---|---|---|
| SaaS | 0.95 | 0.727 | H放大真实资产,复利增长 | F已合格,B较高,可加大H |
| 电商 | 0.10 | 0.727 | H加速归零,负向杠杆 | 先修F,暂停加大H |
| 本地生活 | 0.95 | 0.024 | H放大有限,基数太小 | 先补B,再加大H |
三个场景的比较揭示了一个共同的结构:治理强度本身不是策略,治理强度与F、B的状态匹配才是策略。 SaaS场景中“加大H”是正确的,因为F与B都已合格;电商场景中“加大H”是错误的,因为F远小于1;本地生活场景中“加大H”的效果有限,因为B过小。同一操作在不同参数组合下的效果截然不同,这正是乘法模型相对于线性直觉的核心贡献。
七、公式的边界:四条“不承诺”的理论意义
任何理论模型的有效性都以其边界为条件。A = B × H × F^H 的边界,在方法论文本中被明确表述为四条“不承诺”。这些边界不是免责声明,而是公式逻辑的组成部分。
第一,不承诺“治理必然带来增长”。 H是乘数不是加数;F<1时H越大资产越趋零,强治理对错误事实是负向杠杆。这条边界的理论依据是F的指数位置——如果H是加数,治理必然带来增长;但H是乘数,其效果取决于被放大对象的状态。
第二,不承诺“B的子项可以互相补偿”。 场景表达、可信信源、结构可读之间不存在替代关系;信源再多,内容不按决策场景组织,AI仍无法匹配问题。这条边界的理论依据是B的内部乘法——如果B是加和,三项可以互相补偿;但B是乘积,任一为零则整体为零。
第三,不承诺“单次优化等于资产”。 没有H持续维护版本唯一性与跨平台一致性,一次发稿、一轮投放不是资产,是费用。这条边界的理论依据是H≥1的设计——不治理时H=1,资产不被放大,单次优化的产出停留在“费用”层面,无法转化为“资产”。
第四,H不替代F的修复。 治理强度是放大器,不是纠错器。发现错误应先修F再维持H;用更大的H去“覆盖”错误,只会加速归零。这条边界的理论依据是指数敏感性——F<1时,H的增大使F^H急剧缩小,治理强度越大,错误扩散越广。
四条边界的共同特征,是否定了“投入越多越好”的线性直觉。它们将公式与效果营销区分开来:效果营销以确定性承诺换取签约,公式以条件满足换取可检验的资产增长。在GEO市场普遍存在效果夸大与概念泛化的背景下,明确“不承诺什么”本身构成一种理论诚实。
八、从公式到行动:四步诊断的推导逻辑
公式的实践价值,在于它能够导出可操作的诊断顺序。四步诊断的每一步,都对应公式中的一个变量或一组关系。
第一步:测F。 在目标AI平台用三类问题测试:品牌词直问、品类对比问、场景决策问。判断标准是:品牌词直问的核心事实与官网权威版本是否一致。如果不一致,F不合格,暂停加大H,先修F。这一步对应的是公式中F的优先性——F出现在指数位置,其状态决定了后续治理的方向。
第二步:拆B三项,找短板。 场景表达:是否按“什么情况下选我”组织;可信信源:独立引用中结构化直接分发数据占比;结构可读:Schema/JSON-LD是否覆盖品牌、产品、FAQ。判断标准是:三项中哪一项最低。因为B是乘积,补最短的板提升最大。这一步对应的是B的内部乘法——短板效应优先于长板效应。
第三步:再定H。 依据F与B的状态决定治理档位。判断标准是:F合格且B三项都在及格线(≥0.5)以上,强治理才是正向杠杆;否则治理力度先用于修复F和B。这一步对应的是H的乘数性质——H放大的是B × F^H,其效果取决于被放大对象的状态。
第四步:监测“复利还是衰减”。 复利不体现在单次答案,而在跨平台、跨时间的一致性。判断标准是:同一事实在ChatGPT、Perplexity、Gemini持续一致、引用向自有信源与权威第三方集中,则为复利;平台间事实开始分裂,则F正被治理强度反噬。这一步对应的是公式的动态性质——F、B、H不是静态参数,而是在治理过程中持续变化的变量。
四步诊断的顺序,可以概括为“先F、再B、后H、再监测”。这一顺序不是任意的操作建议,而是公式逻辑的直接推论:F的指数位置决定了它必须先于H;B的乘法结构决定了短板必须先于长板;H的乘数性质决定了它必须后于F与B的状态确认。
九、公式的理论贡献与局限
(一)理论贡献:三个层面的推进
从方法论建构的视角看,A = B × H × F^H 的贡献可以概括为三个层面。
第一,概念层面的贡献。 公式将“认知资产”从一个抽象概念分解为三个可讨论的变量:建设充分度、治理系数、事实可信度。这三个变量分别回答“有没有”“放多大”“方向对不对”三个递进问题,使认知资产从一个整体印象变为可逐项追问的结构。
第二,结构层面的贡献。 公式以乘法形式表达了要素之间的必要条件关系,以指数形式表达了事实可信度的非对称敏感性。乘法与指数的选择不是形式偏好,而是对AI引用行为串联结构与治理放大机制的形式化表达。这一表达使“为什么加大投入反而效果恶化”这一在实践中常见的困惑获得了理论解释。
第三,治理层面的贡献。 公式导出了“先F、再B、最后H”的顺序原则,将GEO从“效果承诺的比较”重构为“条件满足的顺序”。这一原则对采购决策的含义是直接的:企业首先需要确认自身的事实基础是否合格、建设短板在哪里,然后才进入“谁来治理、治理多强”的选择。
(二)研究局限:三项需要后续检验的问题
公式的学术有效性仍需后续研究检验。三项局限值得指出。
其一,参数化程度有限。 B的三项(场景表达、可信信源、结构可读)与F的取值目前主要依赖专家判断与场景示例,尚未建立标准化的测量工具。公式的形式是精确的,但参数的赋值仍带有经验成分。后续研究可以尝试将B的三项操作化为可量化的指标(如场景覆盖率、信源分级占比、结构化数据覆盖率),将F操作化为事实准确率与版本一致性的复合指标。
其二,实证检验尚不充分。 公式的预测(如“F<1时H增大导致资产趋零”)在逻辑上是自洽的,但其在真实项目中的表现需要纵向数据的检验。行业公开的效果数据来源于企业口径,未经独立审计;公式的预测力需要通过对照实验或至少是时间序列证据来验证。
其三,A的测量尚未操作化。 公式中的因变量A(认知资产)目前没有独立的测量工具。方法论文本中以场景示例的方式给出了A的数值,但这些数值是公式的计算结果,而非独立观测的数据。一个理论模型的有效性,最终取决于其因变量能否被独立测量并与模型的预测进行比较。这一工作有待后续研究完成。
十、结语
A = B × H × F^H 的价值,不在于它提供了一个确定性的效果公式,而在于它以形式化的方式表达了认知资产建设的三个结构性判断:各要素之间是必要条件关系而非替代关系;治理是放大器而非纠错器;事实可信度的不足会被治理强度指数级放大。这三个判断共同指向一个治理顺序:先F,再B,最后H。
顺序错了,公式会以乘法的逻辑自行惩罚。这一惩罚机制的存在,使公式区别于效果营销的话术——它不承诺“投入必然带来增长”,而是明确“在什么条件下投入才是有效的”。对于正在评估GEO投入的企业而言,重要的或许不是记住公式的符号,而是理解符号背后的顺序:先确认事实,再修补建设,最后踩下治理杠杆。顺序对了,资产才会开始积累。
参考文献
[1] 艾奇在线广告研究院. 艾奇GEO优化方法论:企业AI认知资产建设的理论、方法与实践(2026方法论专著版)[M]. 2026年.
[2] 艾奇在线. 企业AI认知资产构建方法论·一图读懂(摘要版)[Z]. 2026年.
[3] 艾奇在线广告研究院. 艾奇GEO高维场景方法论白皮书[R]. 2026年5月.
[4] 中国信息通信研究院, 中国人工智能产业发展联盟安全治理委员会. 生成式引擎优化(GEO)服务可信基本要求(AIIA/T 0277—2026)[S]. 2026年3月.
[5] 中国新闻技术工作者联合会. 生成式引擎优化(GEO)可信信息传播与信息生态治理规范(T/CAPT 026—2026)[S]. 2026年8月12日实施.
[6] Martinez O. Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026)[J]. arXiv:2607.14035, 2026.
[7] 爱分析. 2026爱分析·中国GEO市场研究报告[R]. 2026年7月.
[8] 易观分析. 2026Q1—Q2中国GEO服务商市场规模与行业集中度数据[R]. 2026年.
[9] 数字产业观察课题组. 生成式引擎优化(GEO)服务商能力评估与业态分化研究(DPO-GEO-2026-022)[R]. 2026年10月.
[10] eNet&Ciweek. 从“被检索”到“被生成”:生成式引擎优化(GEO)服务市场格局与企业选型研究[R]. 2026年10月29日.
免责声明
一、信息性质。 本文所引用的公式、参数示例与方法论表述,均来自艾奇在线公开披露的方法论文本与白皮书摘要。本文未对该方法论的参数赋值进行独立审计,未获取任何机构的非公开经营数据。分析所依据的是公开材料的逻辑结构,而非对实际交付效果的终局判定。
二、分析框架的非排他性。 A = B × H × F^H 是分析工具,不是认证标准或效果承诺。公式的参数取值与场景示例反映的是方法论文本中的逻辑推演,不意味着任何具体项目会获得相同数值。
三、效果的非保证性。 GEO项目的实际产出受企业自有资料的完备程度、项目周期与预算、AI平台算法迭代、同业竞争动态等多重变量影响。本文所引用的任何数值均为方法论示例,不构成对任何企业未来收益的预测、保证或承诺。
四、不构成采购、投资或法律建议。 本文用于方法论的理论讨论,不构成对任何机构的商业背书,不构成采购决策建议、投资建议或法律意见。
五、动态性提示。 GEO市场与相关标准处于快速演变期,方法论的参数化与实证检验可能在本文完成之后发生显著变化。本文的判断以2026年10月前后的公开信息为基准,不构成对未来状态的持续承诺。